Historické texty z Oxfordu skončily v trénovacích datech OpenAI
Interní zápisy získané Guardianem ukazují, že digitalizované sbírky Bodleian Libraries naplnily trénovací soubor OpenAI. Veřejné oznámení partnerství z března 2025 mluvilo o zpřístupnění děl; Oxford tvrdí, že použití pro strojové učení netajil.
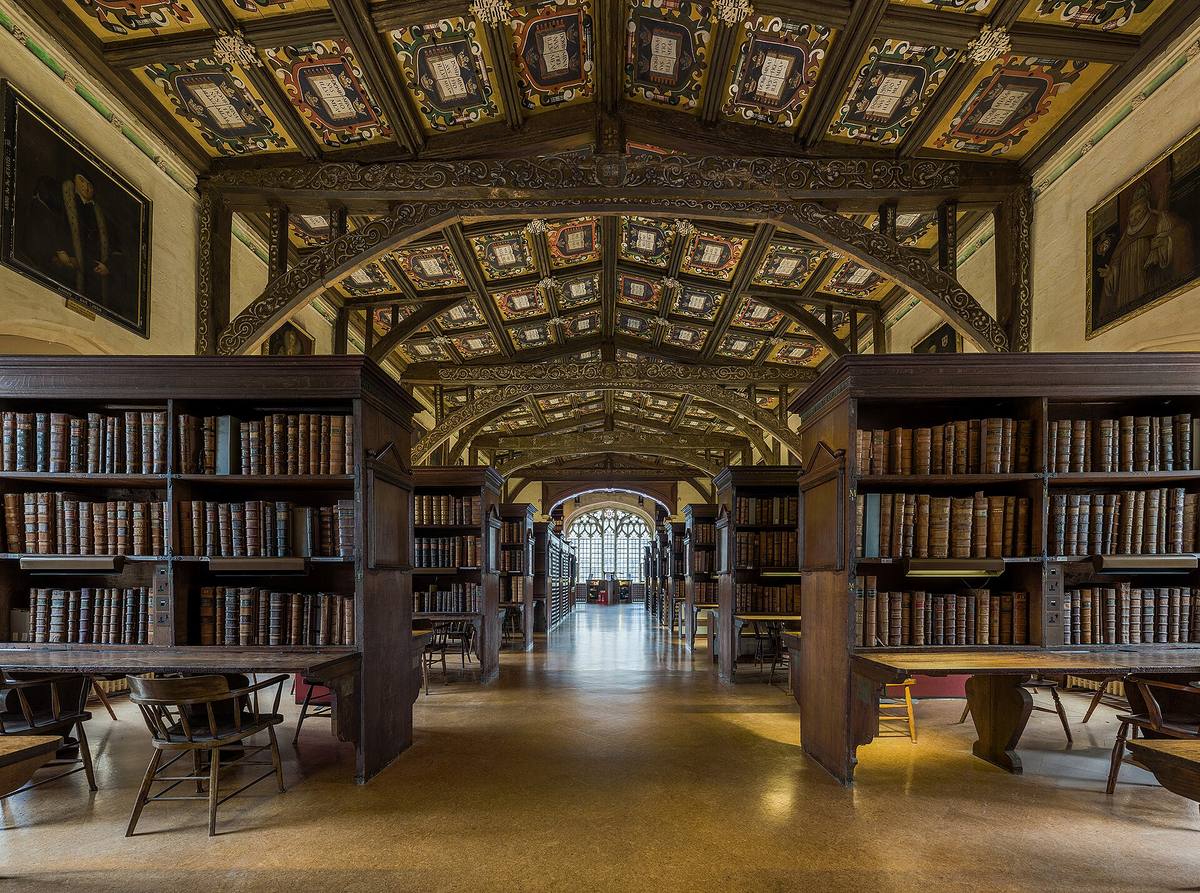
Historické texty z oxfordské Bodleian Library se nestaly jen novým digitálním archivem pro badatele. Podle zjištění Guardianu z 26. září posloužily naskenované materiály také k naplnění trénovacího souboru OpenAI. Deník se opírá o interní zápisy Oxfordské univerzity získané na základě žádosti o svobodný přístup k informacím.
Oxford použití pro trénování nepopřel. Jeho mluvčí Guardianu řekl, že část pro strojové učení nebyla před veřejností ani studenty skrytá. Právě ve veřejném oznámení partnerství však tato informace chyběla: univerzita tehdy popsala digitalizaci, vyhledávání a přístup pro studenty a výzkumníky.
Veřejné oznámení mluvilo jen o zpřístupnění
Pětileté partnerství Oxford oznámil 4. března 2025. Pilot měl převést do digitální podoby materiály bez autorské ochrany, které předtím nebyly dostupné na internetu. Záznam uváděl 3 500 světových disertací z let 1498–1884 a sliboval, že se sbírky stanou prohledávatelnými.
Stejná zpráva představila další části dohody: granty, výpočetní kapacitu, přístup výzkumníků k modelům OpenAI a rozšíření ChatGPT Edu na 3 000 akademiků a zaměstnanců. O předání naskenovaných děl do trénovacích dat modelů v ní není ani věta.
To neznamená, že Oxford sliboval opak. Oznámení výslovně neříká, že by OpenAI data k trénování použít nesměla. Čtenář z něj ale získá užší obraz: firma financuje digitalizaci a univerzita otevře sbírky badatelům. Až interní zápisy citované Guardianem ukazují dalšího příjemce dat, samotnou laboratoř.
Do června vzniklo 125 000 snímků disertací
Guardian uvádí, že do června 2025 Oxford sdílel s OpenAI 125 000 snímků historických disertací. Stránka digitalizačního projektu stejný počet potvrzuje jako zachycené snímky evropských a amerických doktorských prací z 19. a 20. století. Vedle nich vzniklo 429 000 digitálních souborů z ručně psaných lístkových katalogů.
Obě čísla neznamenají stejný obsah. Snímky disertací zachycují vlastní práce, zatímco soubory z katalogů popisují, co knihovna uchovává. Oxford na své stránce výslovně uvádí, že na katalozích a plných textech porovnává běžné optické rozpoznávání znaků s modely v ChatGPT a od dalších poskytovatelů.
Guardian k už zpracovaným materiálům řadí také 10 000 šestnáctistaletých kramářských písní s textovými a hudebními zápisy. U irských státních listin z 18. století, dopisů spisovatelky Marie Edgeworthové a poznámek Dorothy Hodgkinové o penicilinu je formulace opatrnější: zaměstnanci o jejich digitalizaci jednali. Z dostupných podkladů tedy neplyne, že už tyto tři sbírky OpenAI dostala.
Oxford si ponechal práva a slibuje otevřené zveřejnění
Univerzita Guardianu sdělila, že projekt pracuje pouze s díly bez autorské ochrany a svým rozsahem je skromný. Bodleian Libraries si ponechaly práva k digitálním kopiím a použití OpenAI není výhradní. Knihovna je má během několika měsíců začít zveřejňovat na internetu i pro ostatní zájemce.
To je důležitý rozdíl proti nákupu knih jen kvůli datům. Originály zůstávají ve sbírkách a digitální kopie nemají skončit pouze uvnitř modelů. Současná stránka projektu popisuje širší cíl: zjistit, jak ve 23 knihovnách a centrálním skladu zrychlit digitalizaci, zlepšit katalogy a zachovat při automatizaci dohled odborných knihovníků.
Zaměstnanci řešili pověst i spotřebu energie
Interní zápisy podle Guardianu zachycují obavy členů správního výboru knihovny z poškození pověsti univerzity. Další námitka mířila na soulad dohody s ekologickými závazky Oxfordu, protože trénování a provoz velkých modelů spotřebovávají značné množství energie. Veřejná stránka projektu tyto debaty nepopisuje.
OpenAI deníku odpověděla, že chce v dnešních modelech zachovat historické znalosti a zastoupení různých kultur. Neuvedla ale, které modely už z oxfordských materiálů čerpají, kolikrát firma data při trénování použila ani jakou váhu v celém souboru mají. Zpráva proto dokládá tok dat, ne měřitelný vliv na odpovědi ChatGPT.
Partnerství tak má dva veřejné výsledky, které se nemusí vylučovat: knihovna získává zaplacenou digitalizaci a OpenAI čerstvá historická data. Spor je v tom, že druhá část byla v prvním oznámení neviditelná. Oxford ji začal výslovně obhajovat až poté, co interní zápisy získal tisk.
Zdroje
- The Guardian, 26. září 2026 – interní zápisy, použití digitalizovaných materiálů pro trénování a vyjádření Oxfordu i OpenAI
- Bodleian Libraries, 4. března 2025 – veřejné oznámení pětiletého partnerství a popis pilotní digitalizace
- Bodleian Libraries – rozsah projektu, počty snímků a pět pracovních proudů