Modely v Claude Code a Codexu volí z čísel od jedné do deseti téměř vždy sedmičku
Sedm modelů od Anthropicu a OpenAI dalo v měření z 15. října na prosbu o číslo od 1 do 10 sedmičku v 98 až 100 pokusech ze sta. Lidé ji volí zhruba ve třetině případů a doladění podle lidského hodnocení ten sklon ještě zesílí, takže k losování se model nehodí.
Server Root.cz napsal 19. října ve zprávičce „AI si vždy z čísel mezi 1 a 10 vybere 7“, že jazykové modely na prosbu o číslo od jedné do deseti odpovídají sedmičkou. Opírá se o graf, který 13. října sdílel na síti X Adam Zachary Wasserman, a o vlastní pokus: šest modelů na duck.ai (GPT-6, GPT-5.4 mini, Claude Haiku 4.5, Mistral Small 4, gpt-oss 120B a Gemma 4 31B) odpovědělo sedmičkou na českou i anglickou otázku.
Graf ze sítě X je náčrt bez čísel
Wassermanův příspěvek ukazuje tři křivky nad čísly 1 až 10: rovnou čáru náhody, širší kopec lidí a úzkou špičku jazykových modelů nad sedmičkou. Svislá osa ale nemá žádné hodnoty, chybí jména modelů i počet pokusů a křivky jsou hladké, přestože odpovědí je jen deset. Wasserman k němu připsal jedinou větu, podle které je to „nejméně překvapivý graf na světě, pokud rozumíte gradientnímu sestupu“ (přeloženo). Odkud data jsou, neuvádí.
Skutečné měření zveřejnil o dva dny později někdo jiný.
Sedm modelů, tři otázky a sto pokusů na každou
Uživatel Redditu aspiringtroublemaker dal 15. října do skupiny r/dataisbeautiful měření sedmi modelů. Každému položil každou otázku stokrát, pokaždé v čistém kontextu, a to přes Claude Code (claude -p) a Codex CLI (codex exec) ve výchozím nastavení. K otázce vždy připojil „Reply with just the number, no code, no explanation“. Verze obou nástrojů neuvádí. Teplotu, tedy to, jak moc smí model při výběru odpovědi uhnout od nejpravděpodobnější možnosti, v těchto agentech nastavit nejde.
Na prosté „Pick a number between 1 and 10“ odpověděly sedmičkou ve sto případech ze sta GPT-6 Astra, Claude Opus 5.5, Claude Sonnet 5.5, GPT-6 Sol, Claude Haiku 5.5 a GPT-6 Luna, Claude Fable 5.1 v 98. Slovo „random“ v otázce na tom skoro nic nezměnilo, sedmička padla v 97 až 100 případech. Teprve „uniform random“, tedy výslovně rovnoměrně náhodné číslo, rozhodilo dva modely. Opus 5.5 dal sedmičku ve 46 a čtyřku ve 38 případech, GPT-6 Sol sedmičku ve 38 a zbytek rozprostřel po ostatních číslech. Zbylých pět zůstalo u sedmičky v 82 až 100 případech.
Druhý graf zkoušel otázku, ať model vybere číslo, které jiní agenti nezvolí. GPT-6 Astra pak v 96 případech řekl čtyřku a Claude Sonnet 5.5 v 98 případech pořád sedmičku. Opus 5.5 se rozložil mezi jedničku, dvojku a šestku (29, 24 a 34 %).
Agent přitom s dvacetislovnou otázkou posílá 20 až 29 tisíc tokenů kontextu, takže jedno číslo stálo u Fable 5.1 podle ceníku skoro tři centy. Měření nikdo nezopakoval, s pokusem Root.cz i se studiemi níž se ale shoduje.
Claude Code i ChatGPT odpověděly sedmičkou i nám
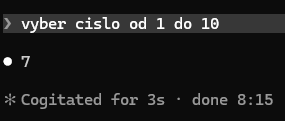
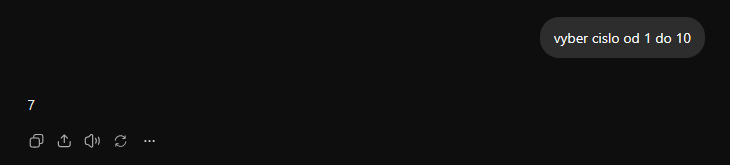
Redakce to 20. října zkusila taky. V 8.15 odpověděl Claude Opus 5.5 v Claude Code na prosbu „vyber číslo od 1 do 10“ sedmičkou. Týž den dal stejnou odpověď ChatGPT ve webovém rozhraní s úrovní uvažování „Velmi vysoká“. Jsou to dva jednotlivé pokusy, ne měření, a nic dalšího se z nich vyvodit nedá.
Lidé volí sedmičku taky, jen ve třetině případů
Agentura YouGov se 12. a 13. září 2024 zeptala 2 241 dospělých v Británii, ať napíšou náhodné číslo od 1 do 10. Podle tabulky výsledků zvolilo sedmičku 33 %, šestku a osmičku po 14 %, pětku 8 %, jedničku 2 % a desítku 4 %. Při skutečné náhodě by každé číslo dostalo kolem 10 %. YouGov o tom napsal 21. března 2025; z téhož průzkumu bere lidská data i graf na Redditu.
Psychologie to zná dlouho. Michael Kubovy a Joseph Psotka z Yaleovy univerzity v roce 1976 popsali, že z 558 kolemjdoucích, kteří měli říct první číslici od 0 do 9, zvolilo sedmičku 28,4 %. Když tazatel sedmičku uvedl jako příklad, klesl její podíl na 16,6 %. Autoři to vykládají tak, že lidé hledají odpověď, která bude vypadat spontánně.
Root.cz k tomu přidává obvyklé vysvětlení: lidé se vyhýbají krajním číslům, prostřední pětce a sudým číslům. Na kraje a pětku data YouGov sedí. Na sudá čísla ne, šestka a osmička jsou hned za sedmičkou.
Doladění podle lidského hodnocení dělá ze sklonu pravidlo
Model nevybírá číslo. Dopisuje další kus textu podle rozdělení pravděpodobnosti, které se naučil z lidských textů, a sedmička v tom rozdělení vede už předem. Peter West a Christopher Potts nechali Llamu 3.1 v základní verzi a ve čtyřech doladěných 1 500krát vygenerovat celé číslo od 0 do 10. Sedmička byla nejčastější už u základního modelu, jen „mnohem méně dominantní“ (přeloženo). Doladěné verze se od rovnoměrného rozdělení odchylovaly zhruba o řád víc a Llama-Instruct dávala sedmičku většinou. Vyšší teplota to podle autorů nespravila.
Proč doladění odpovědi zužuje, popsali Jiayi Zhang a spoluautoři v práci o takzvaném zhroucení na jednu odpověď. Lidé, podle jejichž voleb se model dolaďuje, dávají podle nich soustavně přednost povědomějšímu textu, a model se tak naučí sahat po nejtypičtější odpovědi. U čísla od jedné do deseti je nejtypičtější sedmička.
Každé volání v čistém kontextu navíc začíná od nuly a o předchozích odpovědích nic neví. Když má sedmička v rozdělení pravděpodobnost blízko sta procent, padne v každém novém rozhovoru znovu.
Teplota ani rozepsané uvažování sedmičku neodstraní
Studii, na kterou odkazuje i Root.cz, vydal v únoru 2025 Javier Coronado-Blázquez z Telefónica Tech (arXiv:2502.19965). Položil 75 600 dotazů: šest modelů, sedm jazyků, tři rozsahy a šest teplot od 0,1 do 2,0, sto volání na každou kombinaci. V rozsahu 1 až 10 byla sedmička nejčastější u všech modelů. GPT-4o-mini, Phi-4 a Gemini 2.0 ji volily asi v 80 % případů. Gemini 2.0 ji i při nejvyšší teplotě 2,0 dal v angličtině ve 100 % odpovědí, v ruštině v 80 % a v japonštině ve 34 %. Odchylky dělal jazyk: DeepSeek-R1 na čínskou otázku nejčastěji volil pětku a Llama 3.1 v čínštině i ruštině osmičku.
DeepSeek-R1 přitom vypisuje, jak uvažuje. Zhruba v desetině případů navrhl vzít náhodné desetinné místo čísla π, ale vždy to zavrhl, protože si podle svých slov nepamatuje dost číslic. Asi ve 30 % chtěl číslo odvodit z data nebo času. Rozptyl odpovědí měl ze šesti modelů největší, sedmička ale i u něj vedla ve všech jazycích kromě čínštiny.
Na losování patří generátor, ne model
Pro losování v soutěži, rozdělení do skupin, hru nebo testovací data z toho plyne jediné: číslo má vybrat program. Agent ho umí napsat a spustit, sám od sebe to ale neudělá. Autor měření na Redditu z otázky vypustil „no code“ a žádný z agentů kód stejně nenapsal, takže si o to je potřeba říct výslovně.
V Pythonu stačí secrets.randbelow(10) + 1, v linuxovém shellu shuf -i 1-10 -n 1. Vyzkoušeli jsme obojí. Sto tisíc losů přes secrets dalo sedmičku 10 009krát, tedy v 10,0 % případů, a žádné číslo neuhnulo od deseti procent o víc než 0,4 bodu. Root.cz připomíná, že totéž platí pro hesla: silné heslo modelu vymýšlet nenechávejte.
Zdroje
- r/dataisbeautiful: Asking AI Agents to Choose a Number Between 1 and 10 (15. 10. 2026)
- YouGov: tabulka výsledků, Think of a random number from 1-10 (12. až 13. 9. 2024)
- YouGov: Britons most likely to pick 7 as random number (21. 3. 2025)
- Kubovy, Psotka: The predominance of seven… (1976)
- West, Potts: Base Models Beat Aligned Models at Randomness and Creativity (arXiv:2505.00047)
- Zhang a kol.: Verbalized Sampling (arXiv:2510.01171)
- Coronado-Blázquez: Deterministic or probabilistic? (arXiv:2502.19965)
- Root.cz: AI si vždy z čísel mezi 1 a 10 vybere 7 (19. 10. 2026)
- Adam Zachary Wasserman na síti X (13. 10. 2026)