DGX Spark se 64 GB má poloviční paměť, ale stejnou propustnost 273 GB/s
Nvidia nabízí DGX Spark se 64 GB od 23. října přes šest výrobců za 4 999 dolarů, o čtvrtinu dráž, než loni stála verze se 128 GB. Ta mezitím podražila na 6 950 dolarů. Model o sto miliardách parametrů, který Nvidia slibuje, se do 64 GB vejde jen ve čtyřech bitech a propustnost paměti mu dovolí nejvýš asi 5,5 tokenu za sekundu.
Nvidia rozšířila nabídku stolního počítače DGX Spark o konfiguraci se 64 GB sjednocené paměti, tedy paměti, kterou sdílí procesor i grafický čip. Podle oznámení z 2. října ji od pátku 23. října budou prodávat Acer, Asus, Dell, Gigabyte, HP a MSI, a to od 4 999 dolarů. Sama Nvidia ji nabízet nebude. Čip GB10, systém DGX OS i síťová karta ConnectX-7 na 200 Gb/s zůstávají stejné jako u verze se 128 GB.
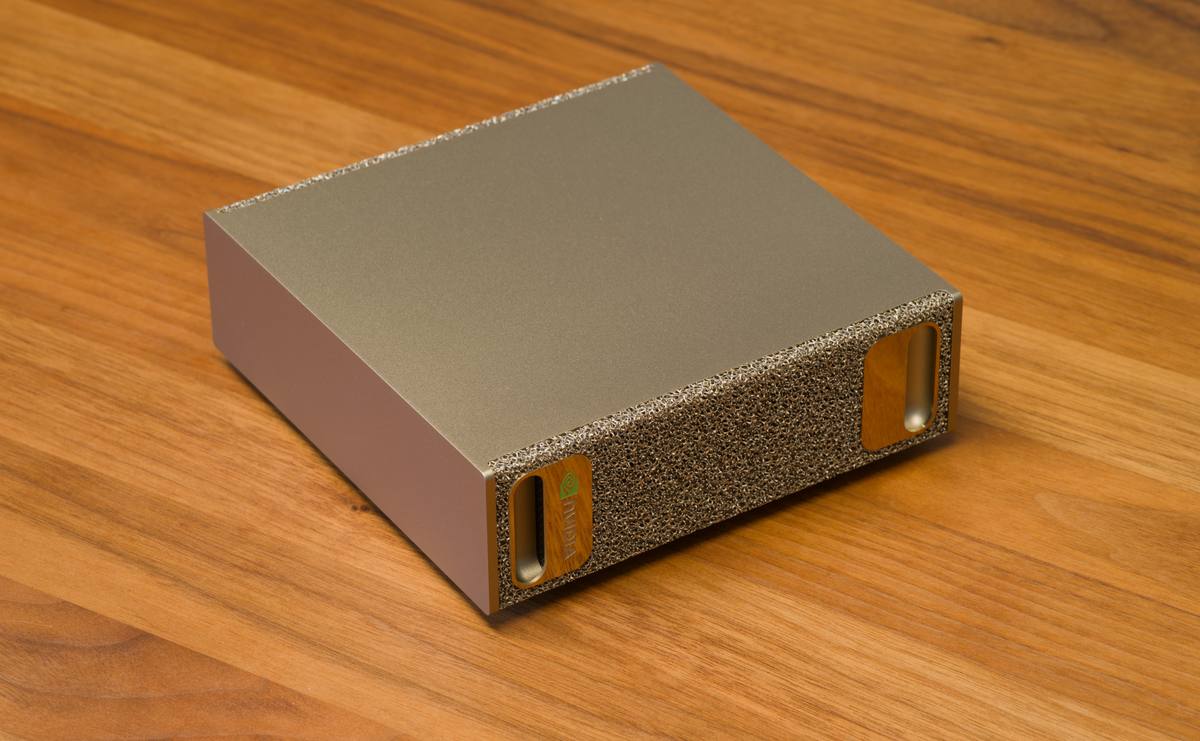
Nezměněná zůstala i propustnost paměti. The Register napsal, že mu Nvidia potvrdila 273 GB/s, a usuzuje z toho, že menší kapacitu dělají paměťové čipy s menší kapacitou, ne menší počet čipů. U verze se 128 GB uvádí dokumentace Nvidie 256bitové rozhraní, šestnáct kanálů LPDDR5x 8533 a právě 273 GB/s.
Gigabajt paměti stojí dvaapůlkrát víc než při uvedení
DGX Spark se 128 GB a 4 TB úložiště přišel na trh v říjnu 2025 za 3 999 dolarů. V únoru 2026 Nvidia zvedla doporučenou cenu na 4 699 dolarů a jako důvod uvedla nedostatek pamětí na světovém trhu. Teď stojí podle The Register i ServeTheHome 6 950 dolarů, o 74 % víc než při uvedení.
Nová konfigurace tak stojí o čtvrtinu víc, než loni stál stroj s dvojnásobnou pamětí. Na gigabajt to dělá 31,2 dolaru u loňské ceny (3 999 děleno 128), 54,3 dolaru u dnešní ceny verze se 128 GB (6 950 děleno 128) a 78,1 dolaru u nové verze (4 999 děleno 64). Za jakou kapacitu úložiště cena 4 999 dolarů platí, oznámení Nvidie neuvádí. The Register píše o polovičním úložišti, ServeTheHome teprve čeká, zda výrobci za tu cenu dodají 1 TB, nebo 4 TB.
Za levnější alternativu považuje The Register systémy s čipy AMD Gorgon Halo, které mají až 192 GB paměti a prodávají se pod cenou Sparku se 128 GB. V testech té redakce byl ale grafický čip GB10 v úlohách AI výrazně rychlejší.
Sto miliard parametrů se vejde jen ve čtyřech bitech
Nvidia píše, že stroj se 64 GB zvládne modely až o 100 miliardách parametrů. V jaké přesnosti, neuvádí. Při čtyřech bitech na parametr zaberou váhy takového modelu 50 GB, v osmi bitech 100 GB, tedy víc, než stroj má. Ze 64 GB pak zbude 14 GB na systém, ostatní programy a mezipaměť klíčů a hodnot (KV cache), kam si model ukládá rozpracovaný kontext. Ta roste s každým tokenem konverzace nebo čteného dokumentu.
Jako rozumnou velikost pro lokální agenty uvádí Nvidia podle The Register modely o 26 až 35 miliardách parametrů, třeba Qwen 3.8 27B. Ten v osmi bitech zabere 27 GB, ve čtyřech zhruba 14 GB.
Rychlost určuje propustnost, ne velikost paměti
Při generování musí stroj na každý token přečíst z paměti všechny váhy, které se na výpočtu podílejí. U hustého modelu, kde pracují všechny parametry naráz, je proto horní mez rychlosti propustnost vydělená velikostí vah. Model o sto miliardách parametrů ve čtyřech bitech dává 273 děleno 50, tedy nejvýš 5,5 tokenu za sekundu. Qwen 3.8 27B vyjde v osmi bitech zhruba na deset tokenů za sekundu, ve čtyřech na dvacet. Skutečnost bývá pomalejší, protože se čte i mezipaměť kontextu.
Modely se směsí expertů (MoE) jsou na tom lépe. Na každý token čtou jen aktivní část parametrů, takže je propustnost brzdí méně. Pro obě verze Sparku platí totéž: stejná propustnost znamená stejnou horní mez rychlosti u každého modelu, který se do menší paměti vejde. Liší se jen v tom, co se do paměti vůbec vejde.
Dva menší stroje vyjdou dráž než jeden větší
Nvidia nabízí dva stroje se 64 GB spojit kabelem QSFP přes porty ConnectX-7 a nastavit je aplikací NVIDIA Sync. Spojená paměť má 128 GB a podle Nvidie pojme modely až o 200 miliardách parametrů. Ve vlastním testu s modelem Qwen 3.8 27B naměřila Nvidia na dvojici až 1,7násobný výkon proti jednomu stroji. Jakou úlohu, délku kontextu a verzi softwaru přitom použila, oznámení neuvádí.
Dvojice za startovní cenu stojí 9 998 dolarů, o 3 048 dolarů víc než jeden Spark se 128 GB. ServeTheHome přitom píše o dvojici „kolem 8 000 dolarů“ a neuvádí, z čeho tu částku má. Svým čtenářům tahle redakce radí koupit spíš jeden stroj se 128 GB než dva se 64 GB. Odvolává se na vlastní zkušenost s clustery a na zásadu, že se nejdřív zvětšuje jeden stroj a teprve pak přidávají další.
Na konci října má přibýt NVIDIA Sync Model Launcher. Ten podle oznámení stáhne Qwen 3.8 27B, spustí ho na jednom stroji i na dvojici a nastaví k němu programovací nástroj OpenCode. Rozdělování dotazů mezi počítače v domácí síti, včetně Sparku, zkouší Nvidia i v betě PAIR, kterou popsal tech-blog.chatujme.cz.