Aleph Alpha vydala Kolibri s 78,8 GB otevřených vah
Německo-anglický Kolibri používá přes 78 miliard parametrů, při každém kroku zapojí 3,46 miliardy. Aleph Alpha doporučuje pro složité úlohy nejvýše 262 144 tokenů, přestože ohlásila milionový kontext. Váhy lze stáhnout pod licencí Apache 2.0.
Aleph Alpha zveřejnila 3. října Kolibri, jazykový model zaměřený na němčinu a angličtinu. Umí podle dokumentace pracovat s dlouhými texty, připravovat volání nástrojů a volit, kolik úsilí věnuje uvažování před odpovědí. Firma ho nabízí pro práci s dokumenty a odborné úlohy, kde si zákazník může provozovat model na vlastních serverech.
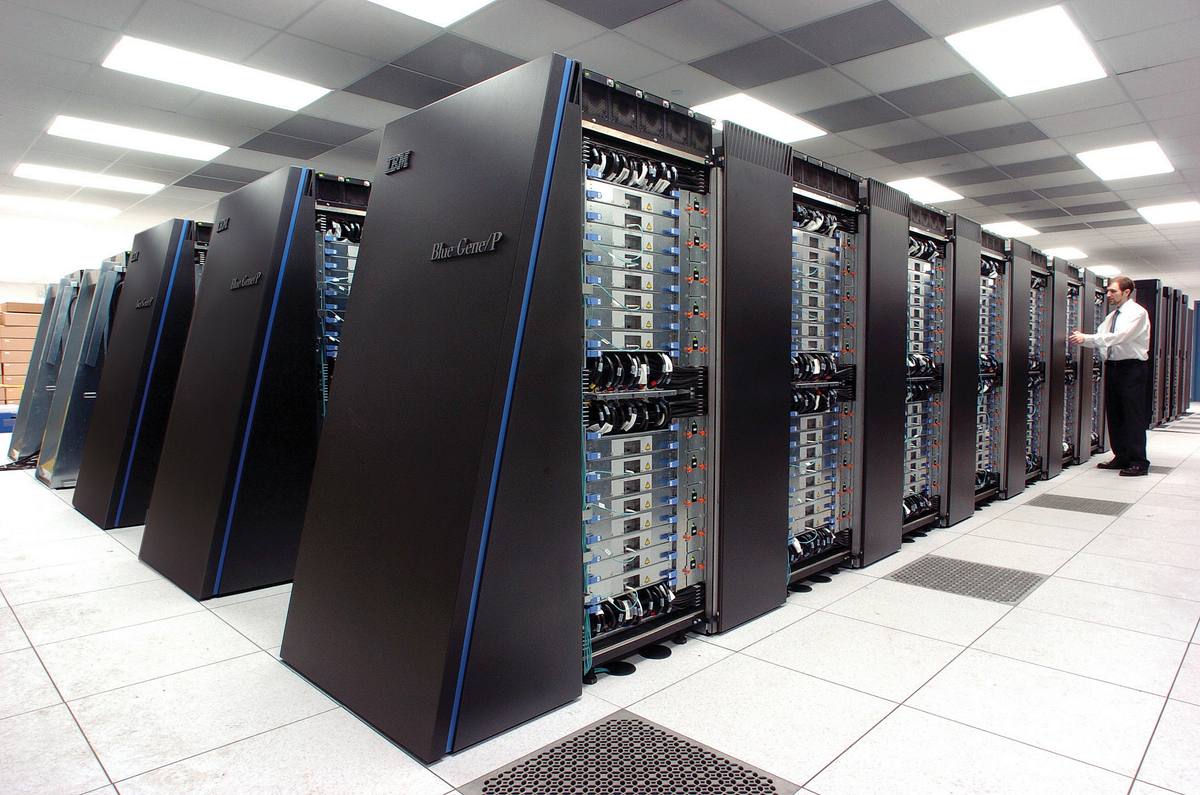
Tři miliardy aktivních parametrů nezmenší celé váhy
Karta modelu uvádí celkem 78,1 miliardy parametrů, tedy naučených čísel, která určují jeho chování. Při zpracování jednoho tokenu, části textu, se využije přibližně 3,46 miliardy. Kolibri patří mezi modely se směsí expertů: při každém kroku vybírá jen část specializovaných bloků místo toho, aby počítal se všemi.
To šetří výpočty, ale celou sadu vah je podle výrobce stále nutné držet v paměti. Součet velikostí 32 souborů .safetensors ve veřejném výpisu Hugging Face dává 78 841 467 208 bajtů, po zaokrouhlení 78,8 GB. Je to náš součet souborů ke dni 5. října, nikoli měření paměti při běhu. Provoz potřebuje prostor také pro průběžná data a obslužný program.
Většina vah je uložená v osmibitovém formátu FP8; některé části zůstávají v šestnáctibitovém BF16. Právě proto má zveřejněná sada přibližně jeden bajt na parametr, místo aby se její velikost blížila dvojnásobku. Dokumentace mezi minimálními sestavami uvádí dvě karty A100 s 80 GB paměti každá nebo jednu H200. Dvě osmdesátigigabajtové karty dávají dohromady 160 GB. Samotných 78,8 GB na disku tedy není příslib, že model poběží na jedné kartě s 80 GB.
Milion tokenů vyžaduje jiné nastavení
Výrobce uvádí podporu až 1 048 576 tokenů kontextu, tedy textu dostupného modelu při vytváření odpovědi. Zároveň ale pro složité úlohy a pro provoz citlivý na rychlost doporučuje nejvýše 262 144 tokenů. Na této délce podle karty proběhla závěrečná fáze trénování s dlouhými texty. Delší vstupy jsou rozšířením nad tento základ; Aleph Alpha tvrdí, že jejich kvalitu a efektivitu ověřila až do uvedeného milionu.
Rozdíl je vidět i v souboru config.json: výchozí mez max_position_embeddings je 262 144. Návod pro delší kontext žádá přepsat tuto hodnotu i maximální délku při spuštění serveru. Provoz má podle něj zajišťovat balíček aleph-alpha-inference, který dodává podporu Kolibri pro vLLM, program obsluhující požadavky na model. Tyto podmínky přebíráme z dokumentace; samotné spuštění jsme nezkoušeli.
Apache 2.0 platí pro zveřejněné soubory
V repozitáři je úplný text licence Apache 2.0. Dovoluje použití, úpravy i další šíření a nestanoví strop tržeb nebo počtu uživatelů. Při dalším šíření je nutné přiložit licenci, označit změněné soubory a zachovat příslušná autorská a další oznámení. Uvedení této licence také nedává obecné oprávnění používat obchodní značky vydavatele.
Aleph Alpha v oddílu o licenčních podmínkách na kartě upřesňuje, že udělená práva pokrývají váhy a konfigurační soubory zveřejněné v tomto repozitáři. Nevztahují se na další nezveřejněné podklady, včetně trénovacích metod a souvisejícího kódu. Otevřené váhy tedy umožňují převzít hotový model, ale samy nepředávají celý postup jeho výroby.
Výsledky pocházejí od výrobce
Aleph Alpha představuje Kolibri jako model s výhodným poměrem schopností a nákladů na provoz. The Decoder při zprávě o vydání upozornil, že některé srovnávané modely pocházejí už z března a dubna 2026. Firemní tabulky proto nelze číst jako nezávislé pořadí všech dnešních modelů. Zde citovaná zpráva sama nepřináší opakování těchto měření.
Trénovací podklady podle karty obsahují také materiál vytvořený čínskými jazykovými modely. V souvislosti s politickým zkreslením jejich odpovědí Aleph Alpha popisuje filtrování těchto dat a dodatečné trénování. Ani vlastní karta však neslibuje bezchybnost. Pro nasazení požaduje ověřování výstupů a uvádí, že Kolibri má člověku připravovat podklady, nikoli bez dohledu rozhodovat nebo provádět důležité kroky.